
吉妮团队提出人类启发的探索算法:让AI学会先找对方向,再寻找答案 | NeurIPS 2026
近日,北京脑科学与类脑研究所吉妮实验室类脑算法论文 “Human-inspired, Task-Dimension-Guided Exploration for Efficient Learning in High Dimensions” 被人工智能顶级国际会议 Neural Information Processing Systems(NeurIPS 2026)正式接收。
这项工作受到同一团队此前关于人类在复杂环境中通过选择性注意和维度化探索实现高效学习的认知科学发现启发,提出了一种新的探索算法——任务维度引导探索(Task-Dimension-Guided Exploration,TDGE),让AI先探索重要任务维度,再逐步寻找具体选择。不同于传统算法主要在大量具体选项之间试错,TDGE通过自动构建由任务维度、特征到具体选项的层级结构,引导AI开展更有针对性的探索,从而提高学习效率。该算法在电影、音乐和电商等真实推荐数据集上显著提升了神经网络算法的探索效率,尤其在新用户数据有限的情况下,能够更快适应用户偏好;其探索过程也呈现出与人类相似的维度化探索模式。
本研究表明,人类通过组织任务维度、选择性探索来降低学习复杂度的认知策略,可以转化为有效的人工智能算法,为复杂环境中的高效学习与自主探索提供新的思路。
研究背景|人类如何在复杂世界中高效探索?
想象你初到一座城市,想挑一家餐厅。几百家店在菜系、价格、环境和服务等方面各不相同。你不会逐一尝遍所有餐厅,而可能先比较菜系,再看看价格或氛围是否影响体验。这样一来,你不仅发现了喜欢哪家店,也逐步弄清了“什么因素决定我的喜好”。
同一团队此前的人类行为研究发现,在尚不了解任务规律时,参与者常常集中探索一个信息维度,在这个维度内比较多个选择,再转向其他维度 (An, et al. 2026)。这种策略被称为“维度隔离采样”(Dimension-Isolating Sampling,DIS)。更系统地采用这种策略的参与者,通常表现得更好。眼动数据也显示,人类的注意力会更多集中在当前探索的维度上。
这一发现提出了一个有趣的问题:能否让 AI 也先判断哪些方向值得探索,而不是在海量具体选项中反复试错?
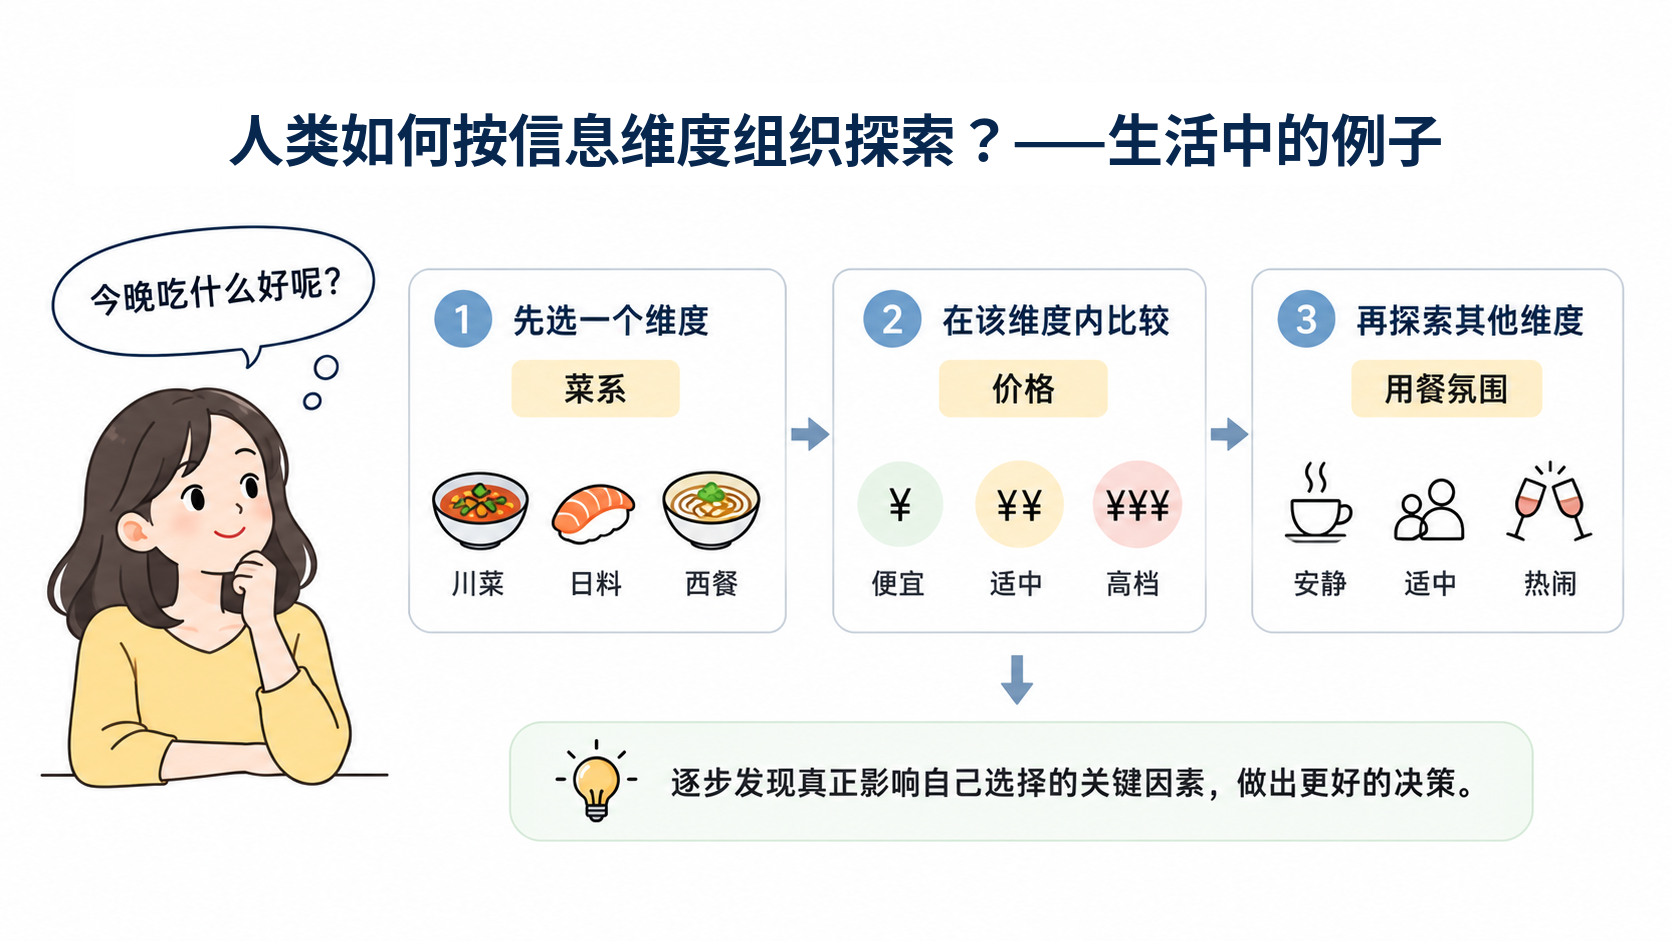
图一|日常生活中的维度化探索:以选择餐厅为例,先集中比较一种因素,再逐步考察其他因素
主要结果|从任务维度到具体选项
算法:先选方向,再选特征,最后选物品
TDGE 把推荐过程组织为三个层级:首先选择值得探索的任务维度(如电影类型或氛围);再在这些维度中选择具体特征(如科幻、悬疑或轻松);最后根据所选特征筛选候选物品,完成推荐。
用户的点击或评分不仅帮助算法调整某件物品的价值,也会反馈到相关特征及其所属维度。这样,算法在学习“用户喜欢什么”的同时,也能学习“下一步应从哪里继续了解用户”。
这些维度来自电影标签等文本信息:研究人员先使用预训练语义模型表示标签,再通过聚类将相近特征组织在一起。TDGE 的创新重点并非发明新的偏好预测器,而是给已有算法加入一种有层次的探索方式。
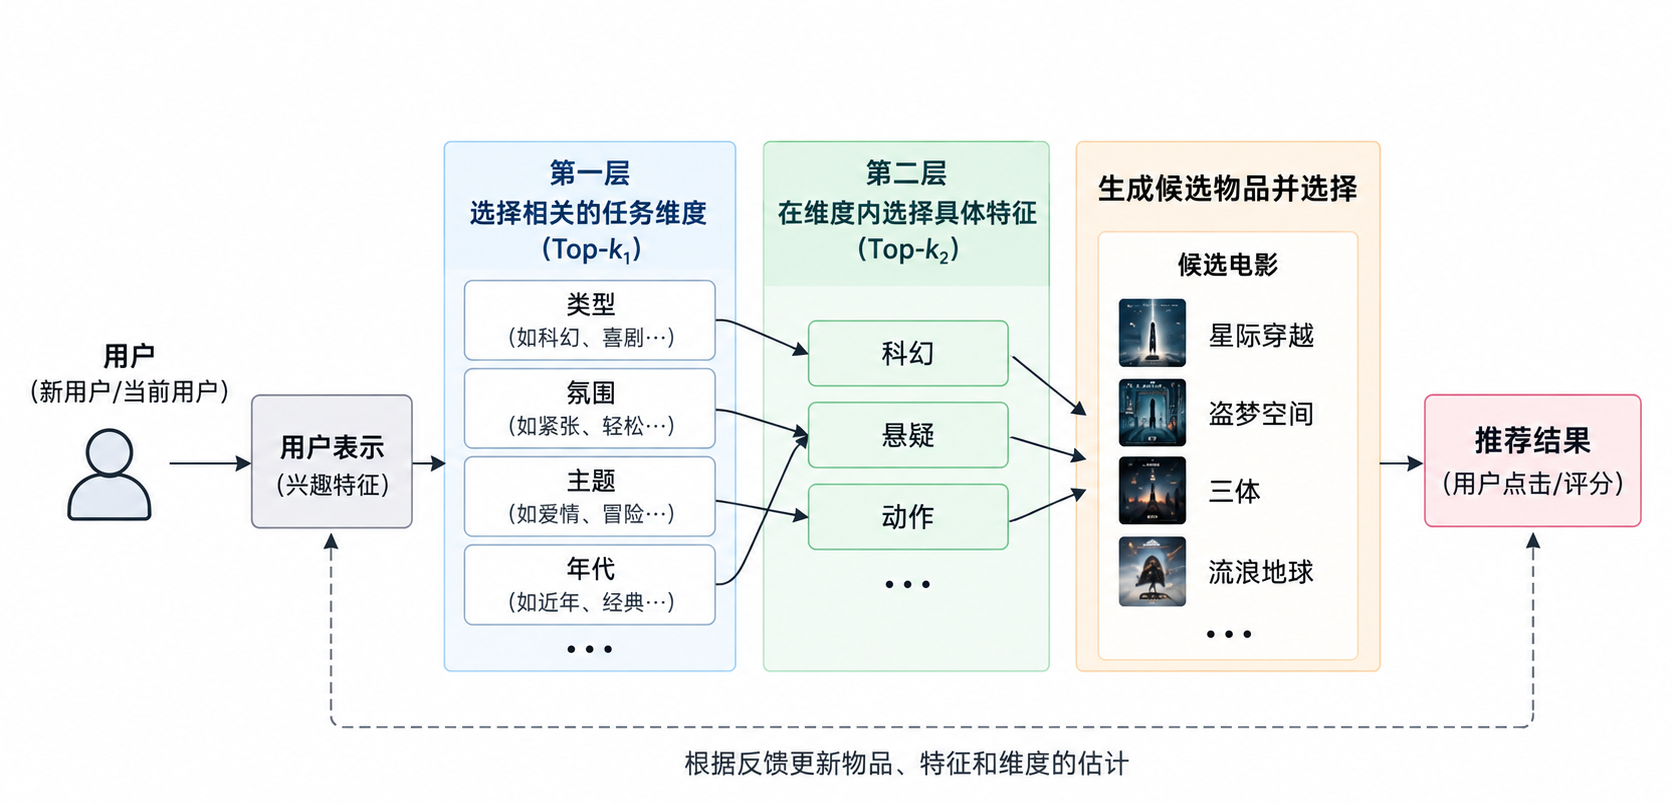
图二|TDGE 的三级探索流程。先筛选任务维度(类型、氛围等),再选择特征(科幻、悬疑等),构建候选电影并推荐;用户反馈用于更新选中路径上各层的估计
实验:试错更少,新用户适应更快
研究团队在 MovieLens-20M 电影、Last.fm 音乐和 Amazon 商品推荐数据集上,将 TDGE 加入三种常用的在线学习算法,与未加入 TDGE 的版本进行比较。评价重点是“遗憾值”:推荐结果与可选最佳结果之间的收益差距,数值越低,意味着试错成本越低。
结果显示,TDGE 在全部六组神经网络算法与数据集组合中显著降低了在线学习的累计遗憾值。面对没有个性化历史记录的新用户,算法在仅进行10次交互的情况下也表现出更快的适应能力:神经网络版本在六组比较中均降低了第 10 轮遗憾值,其中五组达到统计显著性。
例如,在电影推荐任务中,TDGE-NeuralUCB 的第 10 轮遗憾值从 0.239 降至 0.060,下降约 75%。这并不意味着推荐准确率提高了75%,而是说明该实验指标下的推荐损失显著减少。
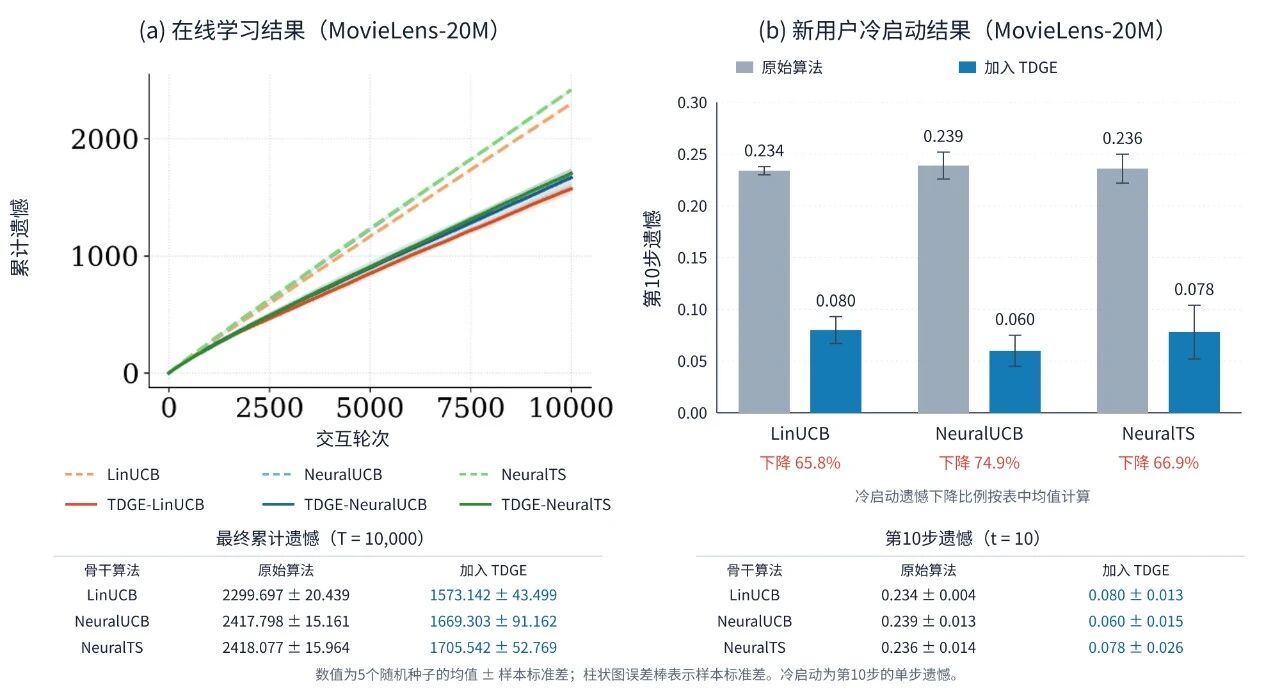
图三|MovieLens-20M 推荐任务中的在线学习与新用户冷启动结果
探索过程:机器也学会了沿一个方向多试几次
除了推荐效果,研究人员还分析了算法的探索轨迹。传统 NeuralUCB 往往会更频繁地在不同语义维度之间切换;加入 TDGE 后,算法更常在同一维度内连续探索几轮,然后再切换方向。这与人类维度化探索的行为特征相似。
当然,行为相似并不等于 AI 复现了大脑的真实神经机制。这项工作的价值在于把人类研究中发现的探索原则,转化为可检验、可推广到不同预测模型的算法设计。
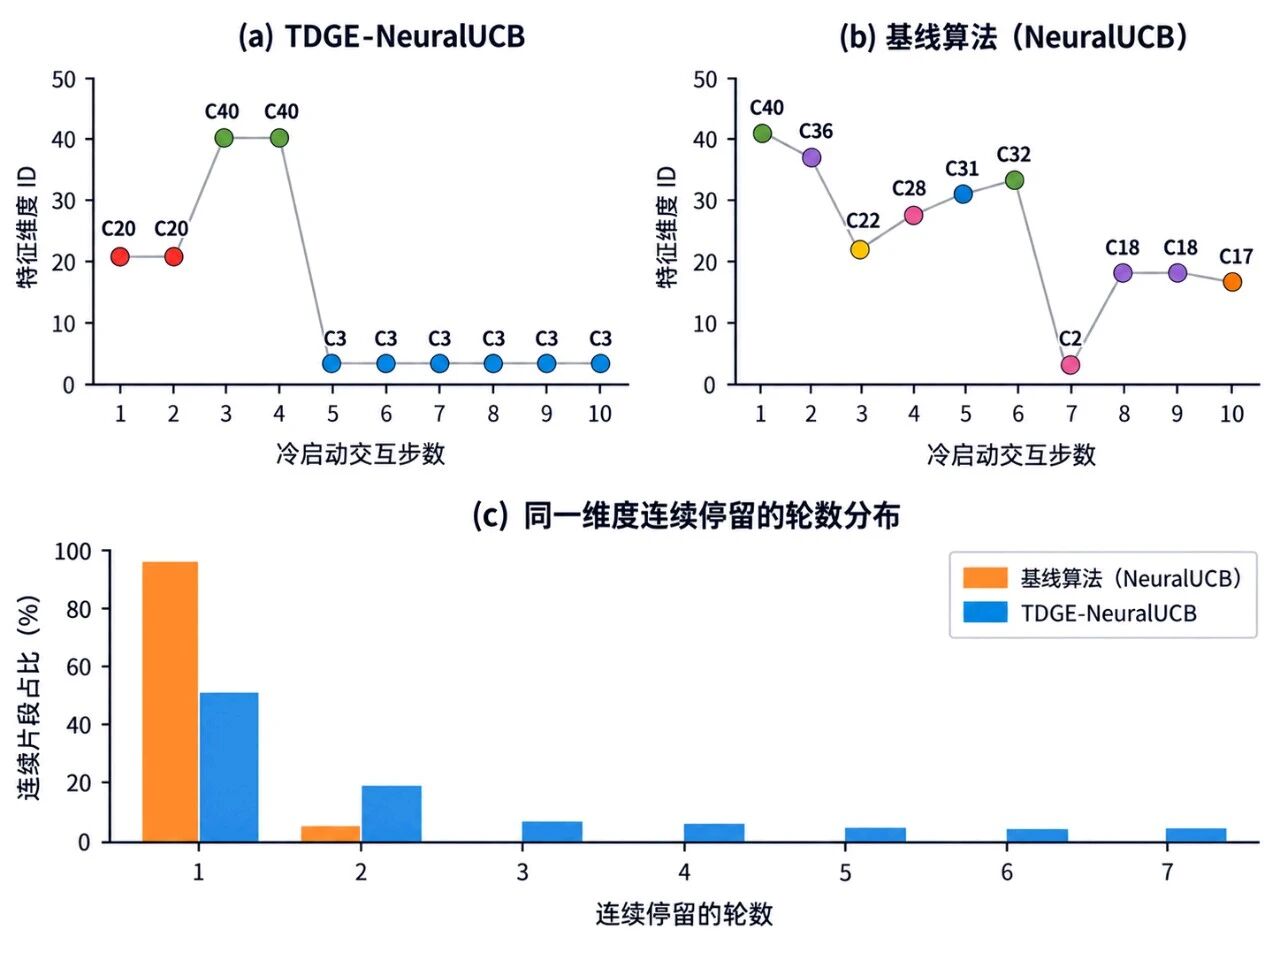
图四|传统 NeuralUCB 与 TDGE-NeuralUCB 的探索轨迹及同一维度连续探索轮数分布
总结与展望|聪明的探索,先找到关键问题
TDGE 提供了一条从认知科学发现走向 AI 算法的路径:高效学习不仅需要更准确地评估选项,也需要更合理地组织探索过程。先识别值得关注的信息维度,再逐层缩小选择范围,可以帮助机器更充分地利用有限反馈。
当前研究主要验证了推荐系统中的单步反馈决策。未来,这种策略能否扩展到机器人自主探索、长期规划,以及在交互中动态发现新任务维度,仍有待研究。
或许,让 AI 更聪明的关键之一,不只是让它学习更多答案,而是让它知道该先探索什么问题。
论文信息
本文第一作者朱璠宇为北京脑科学与类脑研究所吉妮实验室强化学习工程师,第二作者安佳晖为北京脑所—北京师范大学研究生联合培养项目博士生,研究员吉妮为通讯作者。本研究由北京脑所、脑科学与类脑研究国家科技重大专项、中国医学科学院医学创新单元项目、国家自然科学基金等项目资助。